ArtSeek: Deep Artwork Understanding via Multimodal In-Context Reasoning and Late Interaction Retrieval
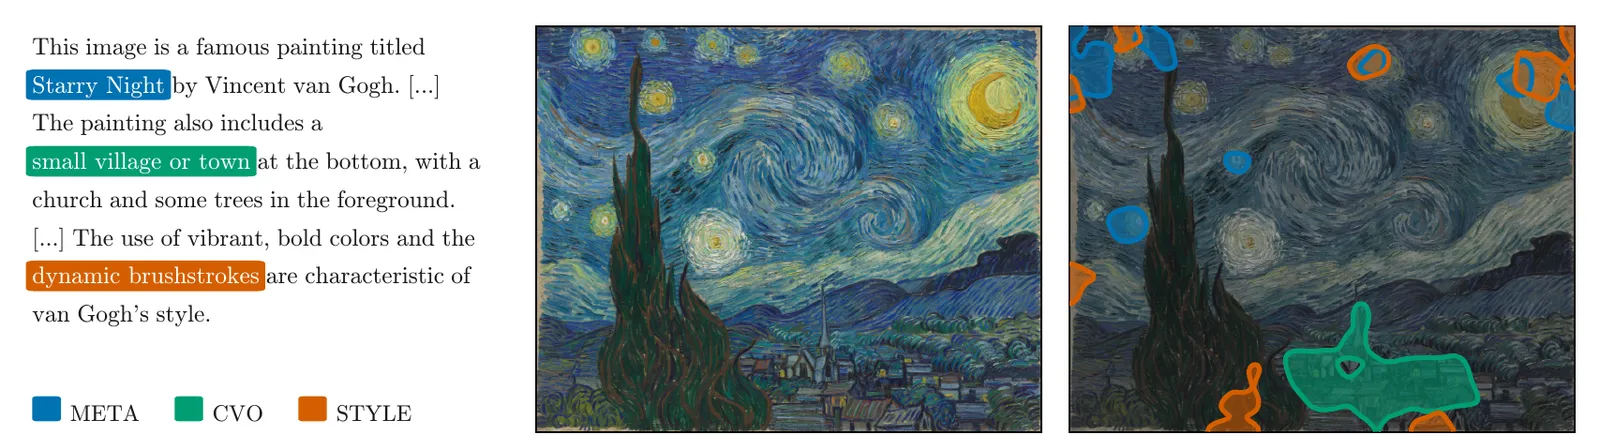
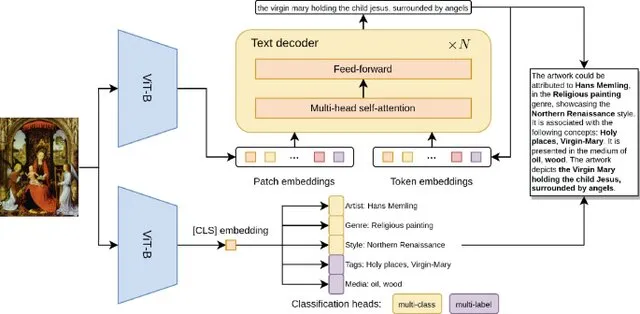
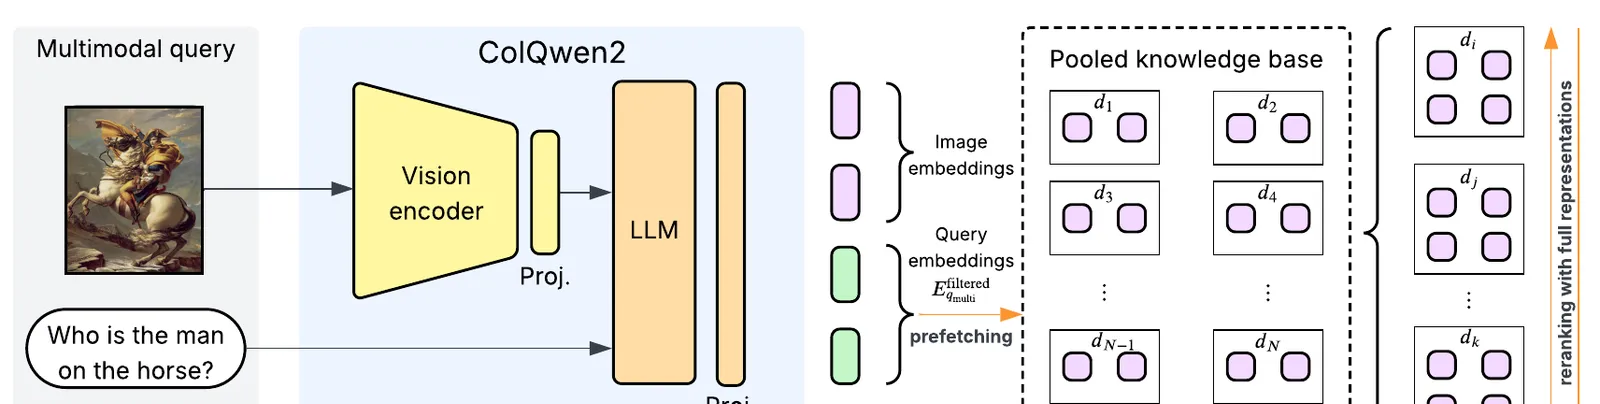
A multimodal pipeline for captioning and visual question answering in the art domain. ArtSeek extends ColQwen2 for multimodal retrieval, introduces WikiFragments — a dataset of multimodal fragments mined from Wikipedia — and a multitask classification framework, unlocking agentic retrieval-augmented generation for multimodal LLMs through in-context learning.